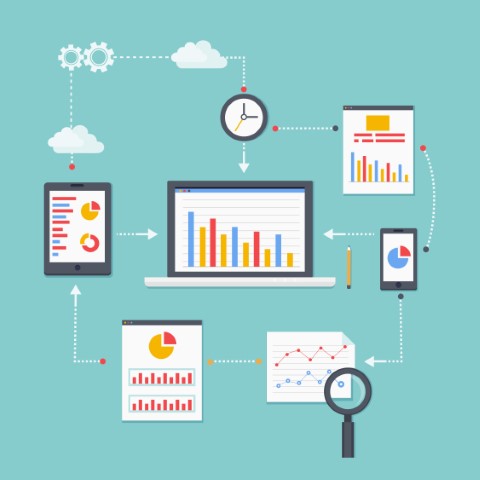
سامانههای مدیریت هوشمند کسبوکار امروز با حجم عظیمی از داده روبرو هستند که بدون دستهبندی صحیح ارزش واقعی ندارند.
دادهها میتوانند ساختیافته (Structured) یا بدون ساختار (Unstructured) باشند؛ هر دسته نیاز به روش تحلیل خاص دارد.
دادههای ساختیافته معمولاً در پایگاههای رابطهای (RDBMSRDBMSRDBMS) ذخیره و با SQL استخراج میشوند.
دادههای بدون ساختار مانند گزارشهای متنی، تصاویر و ویدئوها به فناوریهای Big Data و NoSQL نیاز دارند.
چالش اول، ادغام این دو نوع داده و ایجاد یک نمای واحد از مشتری (360∘ Customer View360^\circ\ Customer\ View360∘ Customer View) است.
ابزارهای ETL (Extract, Transform, Load) در این مرحله نقش کلیدی دارند و دادهها را از منابع مختلف جمعآوری میکنند.
پاکسازی داده (Data Cleansing) از اهمیت بسیاری برخوردار است تا خطاها و مقادیر گمشده حذف شوند.
مرحله بعدی دستهبندی یا طبقهبندی دادهها با الگوریتمهای یادگیری ماشین (ClassificationClassificationClassification) است.
الگوریتمهایی مانند درخت تصمیم (Decision TreeDecision\ TreeDecision Tree) و SVM برای این کار متداولاند.
پس از دستهبندی، تحلیلهای توصیفی (Descriptive AnalyticsDescriptive\ AnalyticsDescriptive Analytics) و پیشبینی (Predictive AnalyticsPredictive\ AnalyticsPredictive Analytics) انجام میشود.
دستهبندی بلادرنگ (Real-Time CategorizationReal\text{-}Time\ CategorizationReal-Time Categorization) در سامانههای هوشمند امر مهمی است.
تکنولوژیهایی مثل راهکارهای استریمینگ داده (Kafka, Flink) این امکان را فراهم میکنند.
تحلیل معنایی (Semantic AnalysisSemantic\ AnalysisSemantic Analysis) بر روی دادههای متنی به استخراج بینشهای عمیق کمک میکند.
خوشهبندی (ClusteringClusteringClustering) برای گروهبندی مشتریان یا محصولات بر اساس ویژگیهای مشترک کاربرد دارد.
استفاده از سیستمهای توصیهگر (Recommendation SystemsRecommendation\ SystemsRecommendation Systems) با روشهای Collaborative Filtering و Content-Based قدرت فروش را افزایش میدهد.
چالش حریم خصوصی و GDPR در تحلیل دادههای مشتریان باید مدیریت شود.
پیادهسازی مکانیسمهای انکانتینگ (AnonymizationAnonymizationAnonymization) و Pseudonymization الزامی است.
یکپارچهسازی با CRM و ERP باعث میشود تحلیلها به نتایج عملیاتی تبدیل شوند.
داشبوردهای BI با قابلیت درگودراپ، تحلیلگران تجاری را از نیاز به کدنویسی بینیاز میکنند.
خودکارسازی گزارشسازی ماهانه فرآیند تصمیمگیری را تسریع میکند.
استفاده از هوش مصنوعی در تشخیص ناهنجاریها (Anomaly DetectionAnomaly\ DetectionAnomaly Detection) میتواند تقلب و خطاهای داخلی را کاهش دهد.
برای مقیاسپذیری، پردازش موازی با استفاده از Hadoop و Spark توصیه میشود.
مستندسازی جریان داده (Data Lineage) و تاریخچه تغییرات (Data ProvenanceData\ ProvenanceData Provenance) در مدیریت هوشمند داده حیاتی است.
دادهکاوی (Data MiningData\ MiningData Mining) و کشف قواعد انجمنی (Association RulesAssociation\ RulesAssociation Rules) مانند الگوریتم Apriori کمک میکند الگوهای پنهان را شناسایی کنید.
یک چالش معمول، نبود فرهنگ دادهمحوری (Data-Driven Culture) در سازمانهاست.
برای رفع آن باید دورههای آموزشی و رقابتهای داخلی (Data Hackathon) برگزار شود.
تیمهای چندرشتهای شامل Data Scientist، Data Engineer و Domain Expert برای موفقیت پروژه ضروریاند.
اندازهگیری بازگشت سرمایه از پروژههای دادهکاوی با معیارهایی مانند افزایش فروش و کاهش هزینه انجام میشود.
بازبینی دورهای مدلها برای بهروزرسانی با دادههای جدید و جلوگیری از پیر شدن مدل (Model DriftModel\ DriftModel Drift) الزامی است.
جمعبندی: دستهبندی و تحلیل دادهها در سامانههای هوشمند کسبوکار نه تنها باعث بهبود عملیات و افزایش فروش میشود، بلکه زیربنای توسعهٔ آینده سازمان را نیز مستحکم میکند.